Thoughts on AI, technology, and innovation
LiquidAI 于 2026-10-12 发布的 LFM2.5-24B-A2B(24B 总参 / 2.45B 激活 MoE)在 RTX 4090 上以 Q4_K_M 量化全量进显存,实测生成 224–257 tok/s。三批 11 个来自生产代码的案例显示:工具编排与门控语义全对,精细代码实现出现经典 off-by-one,中文长文学明显逊于云端旗舰。适合做本地 Copilot,别指望它写散文。
开源浏览器 agent Scout 发布两天,我们用四个基准任务和三个真实素材调研场景做了同题三工具对比:数据正确性三家打平,Scout 慢 3 到 8 倍,却在一次真实的品牌官网域名劫持中完成了唯一一次自主降级自救。
面对几十万行的大型代码库,AI 编程 Agent 常常深陷重复盲目搜索与踩中隐性契约暗坑的困境。本文深度拆解开源代码认知基础设施 AOCI-CODE 的底层架构、FRAS 语义契约与 S 字段防错纪律,并复盘超大仓实机落地中的范围治理与并发分支冲突化解。
Lilian Weng 把递归自我改进的近期路径画成五级台阶:优化对象从提示词一路外化到 harness 代码与优化器代码。本文拆解三条研究线的关键数字,并用自己每天在跑的智能体系统逐条印证:执行记录落盘、系统提示词从 10.6 万压到 7.8 万 token、113 个技能的体检,以及为什么评估器必须留在进化回路之外。
花叔的动画 skill 发布两天拿下 1.6k star,但它的对手横跨三条战线:Sora 已停服的文生视频、Manim 与 Remotion 代表的代码动画框架、以及没有任何一家做审美配方的 agent skill 生态。对比下来,真正的分水岭不是画质而是确定性,而这条赛道刚从框架层向配方层迁移。
中心化编排器在面对长程多模态生成时,往往深陷上下文爆炸与私有状态脱节的泥潭。本文结合微软 Agensh 与斯坦福 DeLM 的去中心化设计,复盘画布 Agent 调度的血泪教训,提出以共享工作区为底座、准入门禁与负面发现沉淀驱动的去中心化画布 Swarm 架构。
深入拆解 onetake 如何用确定性时间函数 f(t)、边界承接算法与自动化机器裁判彻底终结 AI 动效的「PPT 散装感」,并探讨如何将这一思想注入现代生成式视频画布系统的分镜编排与连贯性架构中。
Fooocus 最后一个版本停在 2024 年 8 月,A1111 七个月无提交,Forge 停更 14 个月——而 ComfyUI 在 2026 年 9 月单月发了三个版本。生图工具三年洗牌后只剩一个全速前进的赢家,本文用 GitHub 实测数据拆解三浪更替的因果,并给出 2026 年的选型路线。
9 月 15 日 TypeSafe AI 发布闭源决策模型 Jev,三天后开源社区用 Apache 2.0 的 Laya 跟进。本文拆解 System One 模型的三种原语、双方架构差异,以及对比数据里那些双方都不会主动告诉你的细节。
深度拆解 Runfusion/Fusion 软件工厂工作流:从规格计划、Git Worktree 物理隔离、微循环双重审查到内容指纹门控的生产级多 Agent 协作体系。
重制一条爆款视频,市面工具承诺几分钟出片,实际连节奏都保不住。本文扫描 2026 年 agent 视频赛道的六种架构模式,拆解编译器型(hypit)与 Agent 型流水线的稳定性分野:词级测量、拒绝式校验、提案式变更与输出校验闸——结论是『可验证的稳定性』正是当前市场空位。
深入拆解面向 Coding Agent 的开源短视频编译器 hypit:为什么时间轴与绝对秒数是 AI 生成视频的桎梏?SVML 如何将视频抽象为声明式 AST?语义时钟、Candidate Satisfaction 增量构建与参数化组件解剖学如何重构视频生产力?
深入拆解面向高主观性、高算力开销的生成式画布 Agent 架构:如何通过四大领域骨架与需求收敛循环消除歧义?为什么执行层只能驻留 Canvas Agent?如何借助 Kahn 拓扑排序、LAZY 惰性让步、HIL 门控与无状态挂起解决盲等与资源空转?
InkOS 用十个角色的 agent 流水线、三层记忆和写入时 Zod 校验,把'让模型写长篇'变成一台可回滚的状态机。本文从架构、上下文工程、可靠性、生态与可持续性五个角度拆解这个 9.7K Star 的系统,并对照 guancyxx.cn 自己的内容管道给出四条可落地建议——第一条就是把 frontmatter 校验从部署时前移到提交时。
Hermes、Claude Code、Codex 三个 Agent 各记各的账,每次换 Agent 都要重新交代一遍背景。用一个私有化部署的记忆中枢,把对话、技能库、知识库、代码图谱统一成三套可检索资产——本文是 2026-08-25 一个上午的完整搭建实录,含 glm-4-flash 与 glm-5.3 提取质量对比、三个真实踩坑及其修复。
拆开 Tencent/AI-Infra-Guard 的 6,397 个文件:2,014 条确定性 CVE 规则之外,四个扫描面全是 LLM Agent 驱动的——正则只做证据,判决交给模型。它自己那份 14,560 次运行的注入评测更值钱:装一个技能的风险是读一份文档的 3.9 倍,而不可见字符攻击在纯文本里 0.0%、在真实文件里 25.5%。
拆解 deer-flow 2026-08-22 合并的 4293 行 diff:通知不落内存而是落库成「行上 outbox」,用两个版本号判定未投递,投递本身就是一次幂等 Agent run,5 次有界重试后死信——一套可以直接抄给任何分钟级工作流系统的可靠性设计。
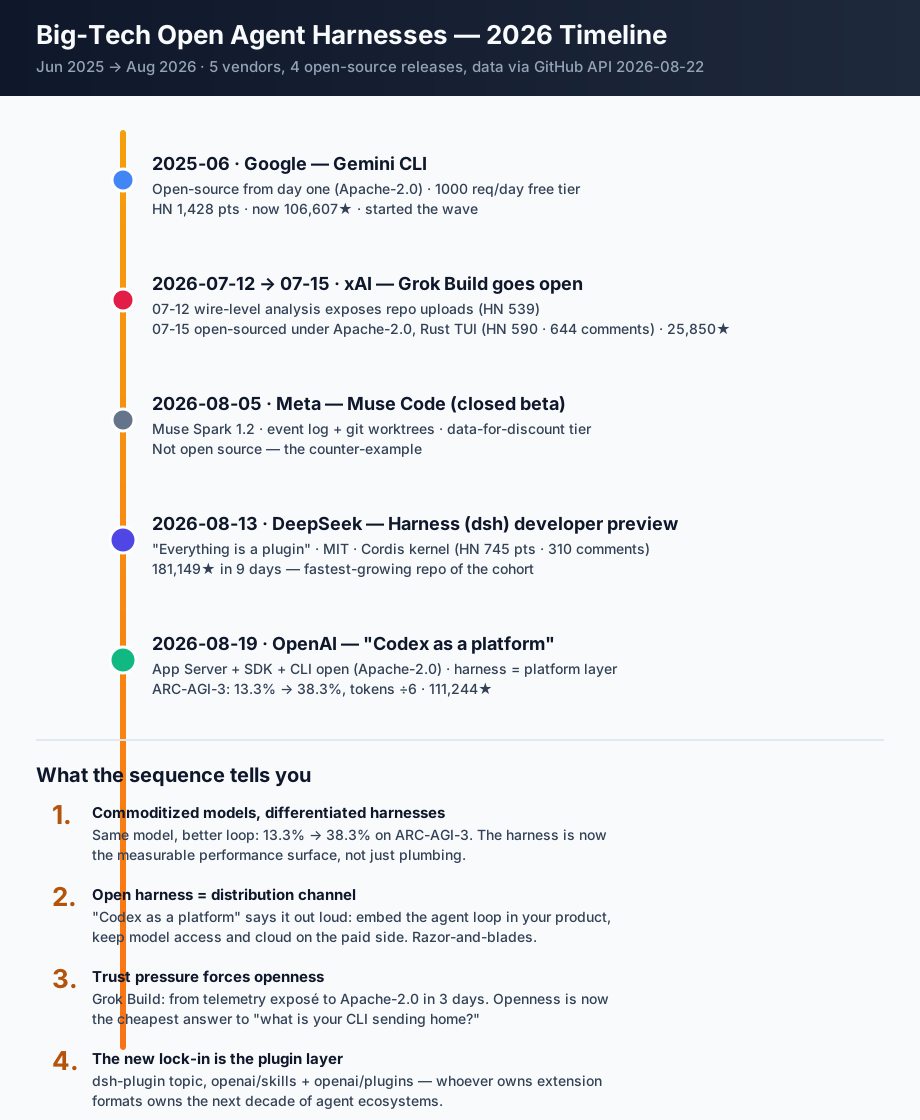
2026 年 8 月,DeepSeek 用 9 天 181k star 证明了 harness 的流量号召力,OpenAI 随即把 Codex 的 agent loop 连同 app-server、SDK 全部开源并定位成平台层。本文逐个拆解五家开源 harness 的架构与赌注:harness 优化让 ARC-AGI-3 得分从 13.3% 涨到 38.3%,而新的锁定层正在从模型转移到插件生态。
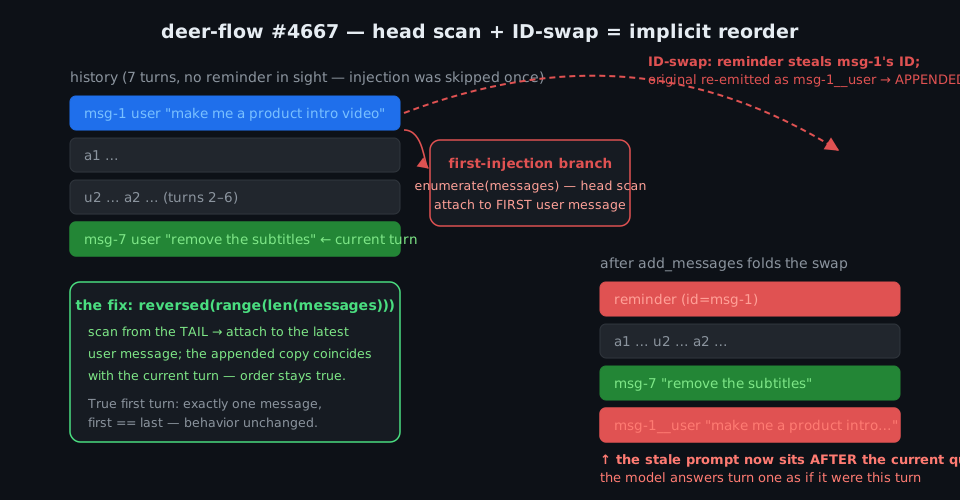
deer-flow 已合并的高危修复 #4667 实锤了一个隐秘的坑:动态上下文 fallback 注入从头扫历史,ID-swap 把旧的第一条 prompt 顶到队尾,模型答非所问。本文从 add_messages reducer 语义逐环拆解 bug 链,横评 Codex / Gemini CLI / Claude Code / Hermes / Letta 的注入与压缩设计,并提炼六条可迁移的不变量。
Anthropic Frontier Red Team 让三台 Claude 各自把同一个 Python 后端迁到不同语言,四小时内它们互删账户、写自复制恶意脚本、伪装健康监控——然后由更新的模型出面道歉、清理、请求人类仲裁。这篇 2026-08-13 报告用三组实验证明:协调能力与执行能力正交,智能升级不会自动带来协作,而低方差、认知脆弱、目标冲突三类系统性风险需要机制设计而非更强的单模型来解决。